La semaine dernière, le 15 septembre, TypeSafe AI a présenté Jev, son premier modèle public « System One ». J’ai eu envie de le tester sur deux outils que j’utilise tous les jours, pour voir ce que ça pouvait vraiment améliorer :
- Etabli, mon setup perso pour bosser avec plusieurs agents, où il faut choisir le bon workflow pour chaque demande ;
facteur, un petit bot Grok qui trie mes mails et fait remonter ce qui demande mon attention.
Dans Etabli, la question c’était « quelle route prendre ? ». Dans facteur, plutôt « est-ce que ce mail mérite de remonter ? ». Deux problèmes assez différents, mais le même besoin : une décision courte et exploitable, sans filer les permissions au modèle.
Jev, en version courte
Jev reçoit un état, répond à des questions fermées et renvoie des valeurs typées avec leurs probabilités. Tu peux le tester dans le Playground ou l’appeler par son API.
Les trois primitives principales deviennent assez parlantes avec un mail ou le choix d’un workflow :
Choicechoisit une catégorie dans une liste, par exemple « à faire », « à répondre », « à relire » ou « bruit » ;Scoreestime un niveau d’urgence ;Noulrépond à une question comme « ce message demande-t-il une réponse ? ».
Le code utilise ces valeurs pour décider s’il accepte la réponse ou reprend son chemin habituel. Pour Choice et Score, confidence résume la distribution des probabilités. Une confiance de 0,8 ne veut pas dire « 80 % de chances d’avoir raison ».
Router Etabli
Une demande envoyée à Etabli peut appeler une réponse directe, une recherche, un plan, une implémentation ou une vérification. Elle peut aussi s’arrêter net parce qu’elle touche à un secret, un déploiement ou une opération destructive.
J’ai branché Jev sur le choix de la route. Il reçoit un état limité aux informations utiles et propose une option dans une liste fermée. Le code continue de décider pour les routes protégées, les permissions et l’état réel du plan.
Voici une version simplifiée de l’appel. Le seuil 0.7 est illustratif, à ajuster sur ses propres cas. L’extrait choisit une route, il ne lance aucune action : les contrôles de permissions restent obligatoires avant toute exécution, quelle que soit la confiance de Jev.
import { choice, TypeSafeClient } from "@typesafe-ai/sdk";

const jev = new TypeSafeClient();

const { answers } = await jev.systemOne({
  state: {
    demande: "Redéploie la prod avec le nouveau token",
    contexte: "repo perso, déploiement Coolify, secrets en variables",
  },
  questions: {
    route: choice("Quelle route pour cette demande ?", {
      answer: "question directe, pas de code",
      research: "il faut chercher avant de répondre",
      plan: "travail multi-étapes, un plan d'abord",
      implement: "modification de code",
      review: "vérification d'un changement",
      stop: "secret, déploiement ou opération destructive",
    }),
  },
});

const route =
  answers.route.confidence >= 0.7
    ? answers.route.choice
    : routeDeterministe(); // Keep the existing deterministic fallback.
Six options, pas une de plus. Si Jev hésite, le routeur déterministe reprend la main, et personne ne s’en plaint.
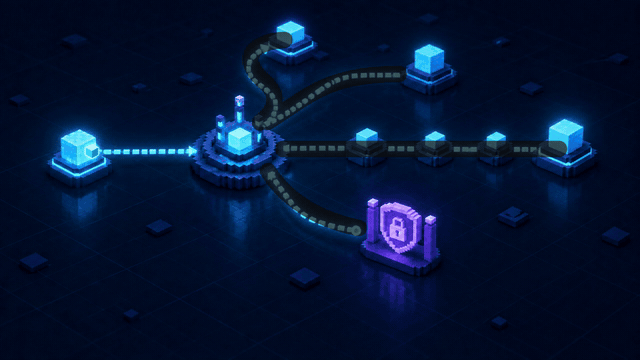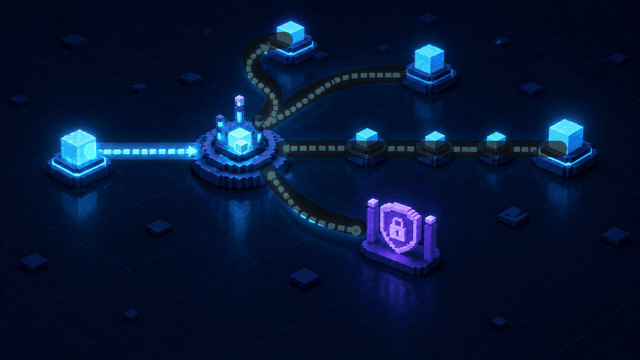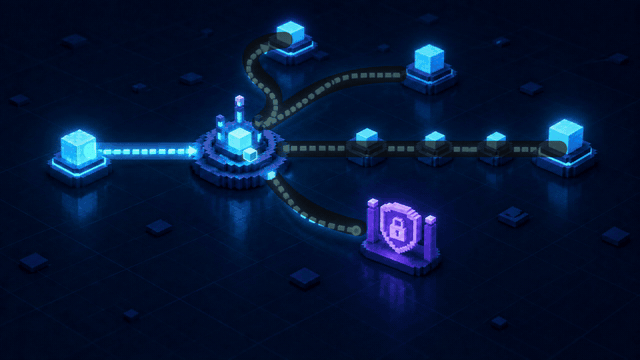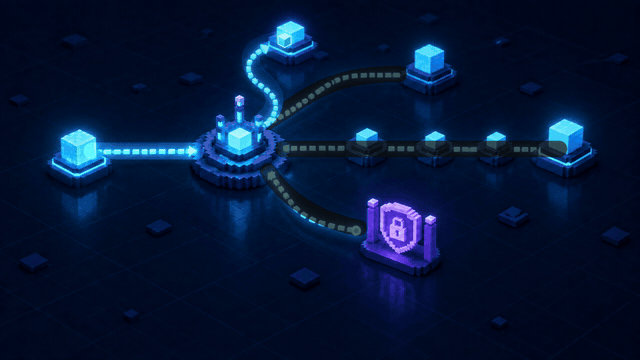
Je ne l’ai pas activé d’un coup, évidemment : d’abord en shadow, à comparer ses réponses au routeur existant, puis en réel sur le seul périmètre validé. Sur un corpus de 30 cas rejoués trois fois, le routeur a atteint 93,3 % de précision brute, 100 % en ne gardant que les réponses assez sûres, avec 64,4 % de couverture et un p95 à 349 ms. En gros deux décisions sur trois ; le fallback déterministe gère le reste.
J’ai ensuite testé un autre montage pour économiser des tokens. Jev propose une catégorie qui permet de choisir des instructions compactes, déjà écrites, pour le LLM. Ça lui évite de relire les documents de routage et de choix du workflow. Dans la version activée sur Pi, le code fixe la route et refuse toute proposition de Jev qui la contredit.
Sur sept tâches rejouées trois fois, ce candidat a réduit de 39,62 % les tokens du LLM traditionnel : 1 472 609 contre 889 124. Le gain mesure l’ensemble Jev et instructions compactes. Les résultats de notre grille sont restés identiques, avec deux tâches toujours en échec dans les deux versions et les cas protégés préservés. Je visais 50 %, je ne les ai pas atteints.
Ce petit benchmark interne a servi à ajuster le candidat au fil des essais. Il couvre les routes de planification, d’implémentation et de revue testées à ce moment-là, sans prouver qu’on gagnera autant sur d’autres tâches. La route plan-implement, ajoutée ensuite, n’entre pas dans ce chiffre. Les mesures et leurs limites sont dans le rapport de campagne.
Trier mes mails
Pour les mails, je pars d’un problème beaucoup plus banal. Ma boîte contient quelques messages importants au milieu des notifications de plateformes, alertes de dépôts, spams et newsletters. Un chaos à naviguer tous les matins.
J’avais déjà un serveur MCP capable de chercher, lire les messages et préparer un brouillon sous conditions. Il plafonne le texte renvoyé et ne transmet pas le contenu des pièces jointes. ALLOW_SEND autorise à la fois les brouillons et l’envoi. Le client qui appelle le MCP doit donc gérer l’accord humain avant chaque opération.
Par-dessus, un brainstorming hyper long (quelques secondes) et facteur est né : le bot Grok qui appelle le MCP. Je lui demande de faire ressortir ce qui attend une action et de laisser le reste dans des compteurs.
Dans un passage récent, il a affiché cinq éléments à traiter et trois à relire, ces derniers marqués « conf basse ». Voici le rapport abrégé et anonymisé :
attention · 8

à faire
- vérifier une alerte de sécurité
- vérifier une autorisation OAuth GitHub
- vérifier une seconde autorisation OAuth GitHub
- vérifier une connexion à un compte de voyage
- noter la fin d'un abonnement

à répondre
(aucun)

à relire
- un guide de recherche d'emploi
- une notification d'import de projet
- une actualité d'un projet suivi

silence : bruit 3 · dépôts 12 · emploi 7 · news tech 5
Ce passage montre ce que Grok affiche. Il ne contient pas de trace d’appel à Jev, donc je ne peux pas lui attribuer ce résultat. Même la mention « conf basse » ne suffit pas à dire d’où vient la confiance.
Pour brancher Jev sur ce triage, je décomposerais la décision en petites questions : une catégorie avec Choice, une propriété avec Noul, puis un niveau d’urgence avec Score. Le LLM pourrait ensuite rédiger le rapport à partir de ces signaux.
Voici un exemple d’appel pour ces trois signaux. Il illustre l’intégration à vérifier sur facteur. On réutilise le client jev du premier exemple ; from, subject et body viennent du mail :
import { choice, noul, score } from "@typesafe-ai/sdk";

const { answers } = await jev.systemOne({
  state: { from, subject, body },
  questions: {
    category: choice("Où classe ce mail ?", {
      "à faire": "demande une action autre qu'une réponse, y compris une alerte à vérifier",
      "à répondre": "attend une réponse",
      "à relire": "à lire un jour, sans urgence",
      bruit: "spam ou message sans action ni intérêt de lecture ; exclure les alertes à vérifier",
    }),
    humain: noul("Le message vient-il d'un humain ?"),
    urgence: score("Quel niveau d'urgence ?", [
      "peut dormir une semaine",
      "à voir aujourd'hui",
      "à traiter dans l'heure",
    ]),
  },
});
Pour montrer le rangement du résultat, voici la branche la plus simple. mail est le message courant, rapport la liste à afficher et silence le compteur. Ce n’est pas toute la politique de triage : avant de masquer des mails automatiquement, il faut aussi gérer les réponses incertaines et mesurer les erreurs.
if (answers.category.choice === "bruit") {
  silence++;
} else {
  rapport.push({
    mail,
    categorie: answers.category.choice,
    urgence: answers.urgence.score,
  });
}
Pour les réponses, je garderais une étape explicite avant le brouillon : le LLM propose le texte, je le valide, puis le client appelle le MCP. Jev pourrait signaler qu’un mail attend une réaction ; l’autorisation d’écrire ou d’envoyer resterait à gérer séparément.
Le schéma que j’ai gardé
Je garde le chemin suivi dans Etabli comme point de départ pour poursuivre le travail sur facteur :
sources vérifiables
    ↓
état borné et versionné
    ↓
jugements typés avec probabilités
    ↓
politique déterministe et abstention
    ↓
action réversible ou checkpoint humain
    ↓
reçu, mesure et possibilité de rollback
La décision de Jev reste une entrée parmi d’autres. Le code connaît déjà les actions autorisées, les fallbacks et les moments où il faut demander confirmation.
La calibration se mesure sur un ensemble de réponses. Pour choisir les seuils de confiance, il faut un corpus représentatif, suivre les abstentions et vérifier les erreurs.
Dans Etabli, ça veut dire conserver la question, le modèle, les seuils, les répétitions, les fingerprints du code chargé, la qualité, la latence et le test de rollback. Pour facteur, il faudra surtout annoter de vrais messages et regarder les erreurs de triage avant d’automatiser davantage.
Les limites
La documentation de jev mentionne des limites sur les nombres, les dates, l’indirection, le contexte inutile et les contenus adversariaux. Je garde donc quelques règles simples :
- Jev peut estimer qu’un texte exprime une urgence, mais le code compare les dates ;
- il peut classer une intention, mais il ne crée pas une permission ;
- il peut repérer un signal, mais il ne remplace pas une validation métier ;
- l’état envoyé au modèle contient uniquement les champs nécessaires ;
- une action irréversible garde une barrière dans le code ou une confirmation humaine.
Les données envoyées au fournisseur comptent autant que le résultat. Pour un mail ou une donnée métier, je veux savoir exactement ce qui quitte la machine, et pourquoi.
Avant d’ajouter Jev quelque part, je regarde trois choses : la décision doit être fermée, l’incertitude doit changer le comportement du système, et un fallback déterministe doit rester dispo. Sinon, un if, une validation de schéma ou un LLM classique fera souvent mieux l’affaire.
Pour creuser un peu
Le répertoire communautaire Awesome Jev rassemble d’autres expérimentations :
- Jev Ultrafast pilote un navigateur : Jev choisit l’opération et l’élément DOM ;
- fast-jev-compaction nettoie le contexte d’une session Claude Code ;
- Jevmail est une application locale qui lit Gmail sans le modifier et appelle Jev via Vercel AI Gateway pour le triage ;
- pg-jev filtre des lignes PostgreSQL en langage naturel.
Ce sera peut-être une hype de passage, je n’en sais rien. Mais expérimenter sur des modèles avec des paradigmes un peu différents, c’est plutôt sympa.